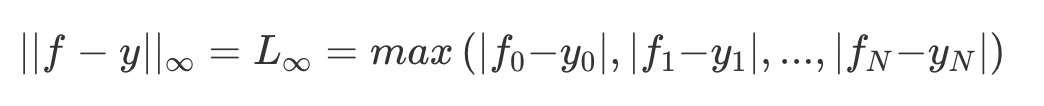Quiver에서 시계열 예측하기
Time series forecast는 분석에 있는 시계열을 시간상 앞으로 연장하는 예측 플롯을 만듭니다. 예측 유형, 학습 범위와 계수 조건을 화면에서 구성하며 결과 시계열에 다른 Quiver 변환을 이어서 적용할 수 있습니다.
입력과 출력은 Time series입니다. 표준 Quiver 카드로 지원하고 transform table 안의 변환으로는 지원하지 않습니다.
선형 예측 만들기
상품 매출 시계열을 예측하는 예시입니다.
- 분석 상단의 Time Series로 검색 창을 열고 예측할 시계열을 추가합니다.
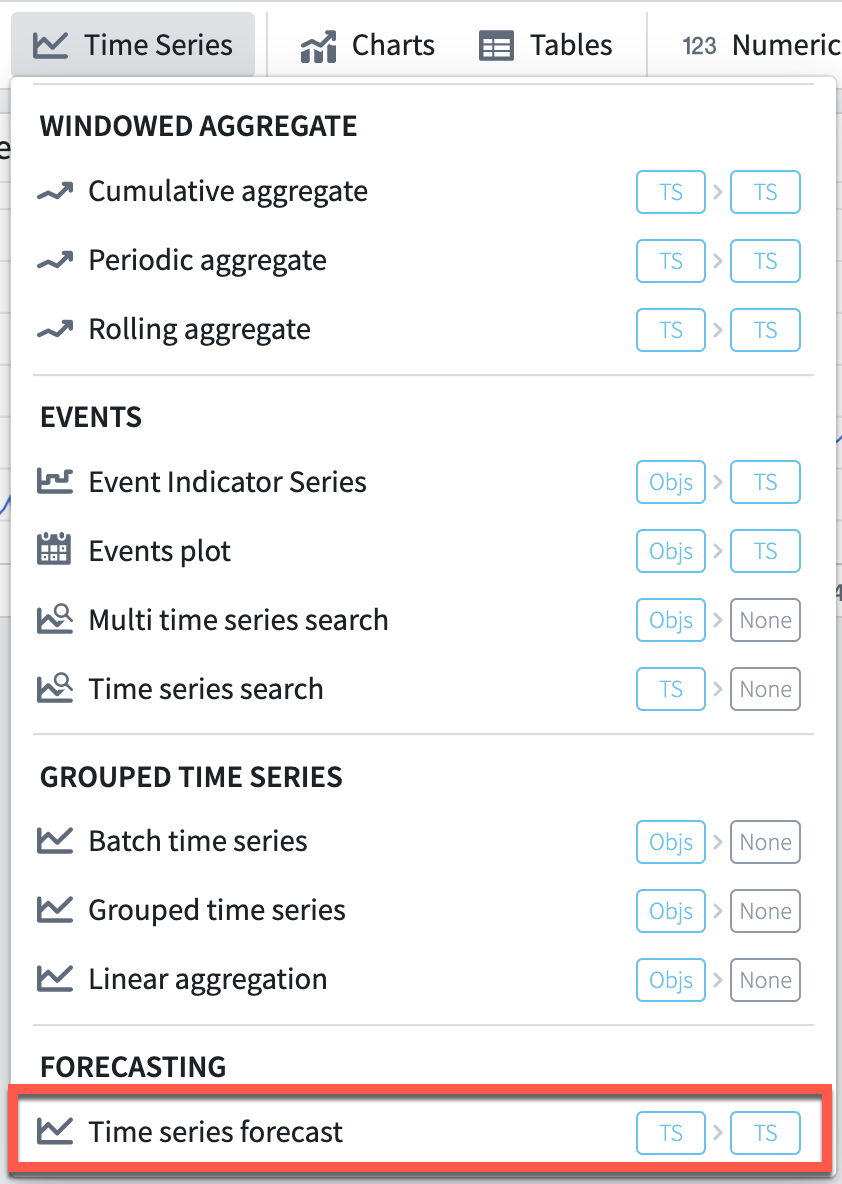
- Time Series 메뉴에서 Time Series Forecast를 선택합니다.
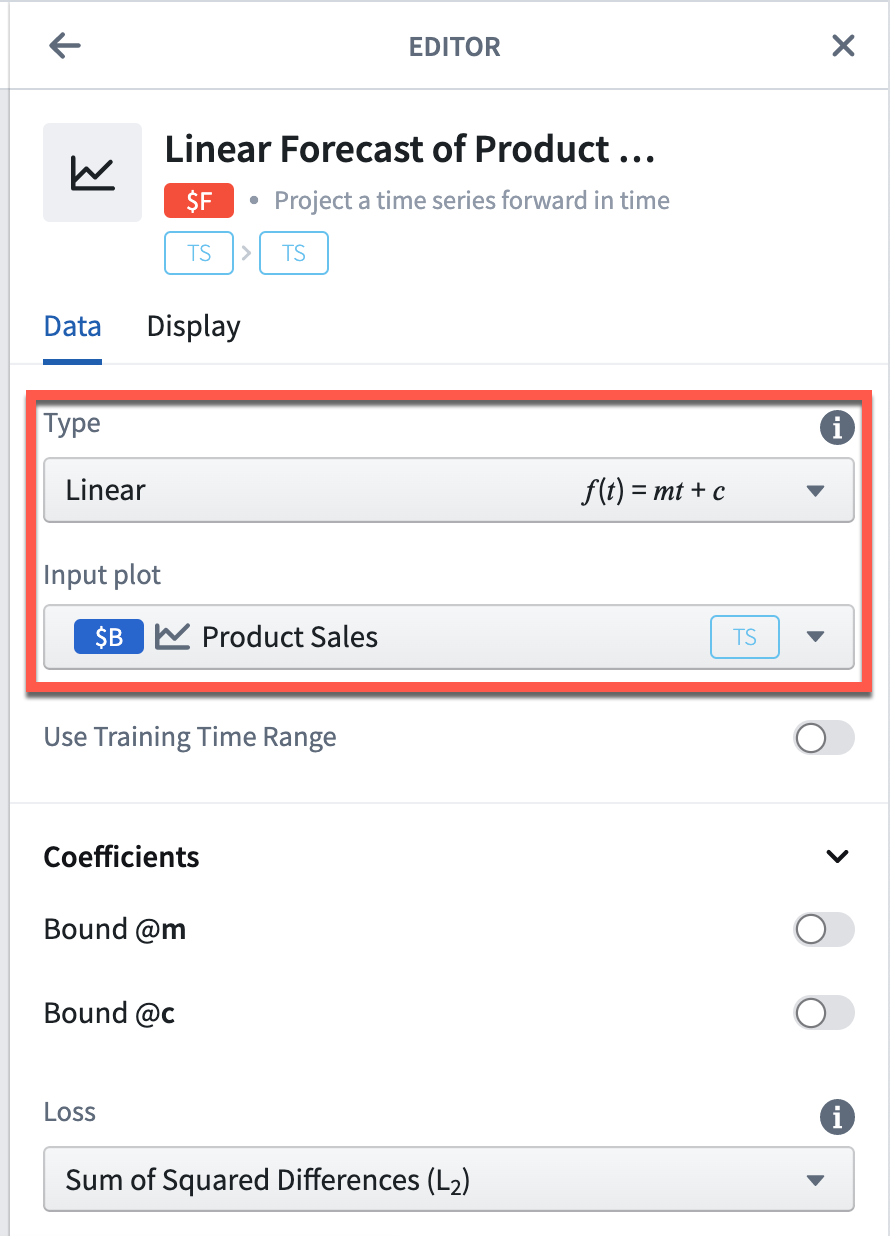
- 예측 편집기에서 Linear 유형을 선택하고 앞에서 추가한 플롯을 입력으로 지정합니다.
기본적으로 입력 플롯의 전체 범위에 적합한 선형 시계열을 만듭니다. 시간축 범위는 원래 입력과 같으므로 더 먼 미래의 예측을 보려면 X축을 축소하여 범위를 넓힙니다.
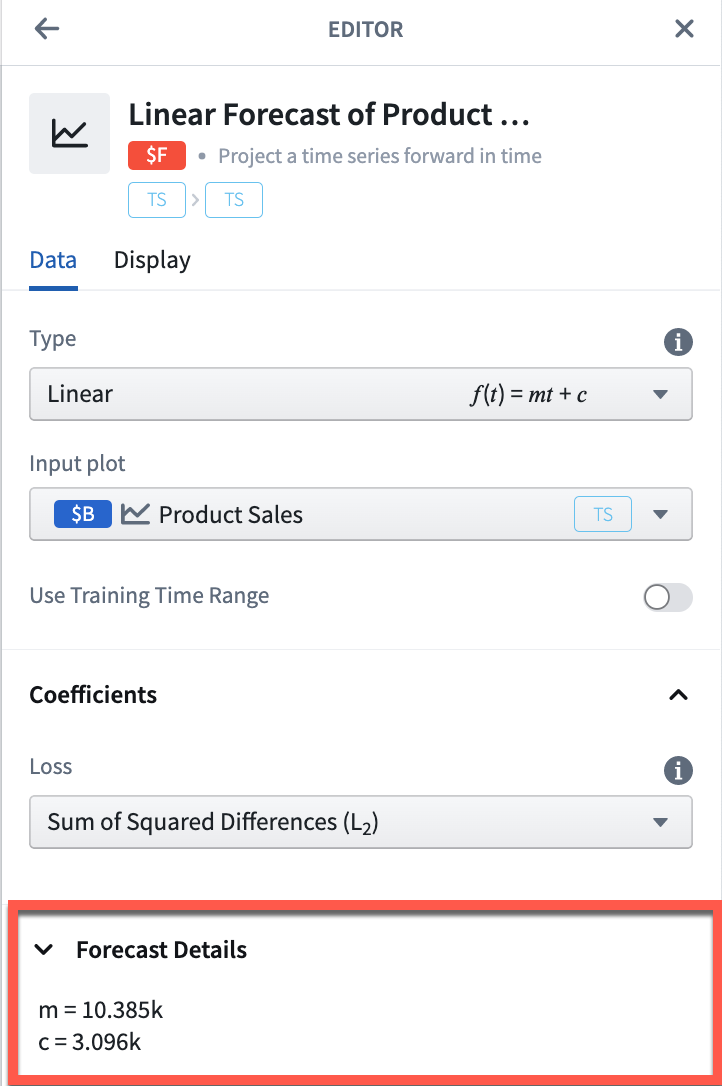
Forecast Details에서 계수를 확인합니다. 이 선형 예시의 m은 기울기이고 c는 절편입니다.
학습 범위와 계수 제한
학습 시간 범위
Use Training Time Range를 켜고 시간 범위 매개변수를 선택하면 해당 기간만 사용하여 적합합니다.
예시에서는 전체 이력 대신 2015~2020년을 사용하므로 기울기와 절편이 달라집니다. 향후 동작을 설명하는 데 더 관련 있는 기간을 골라 학습에 사용할 수 있습니다.
계수의 경계
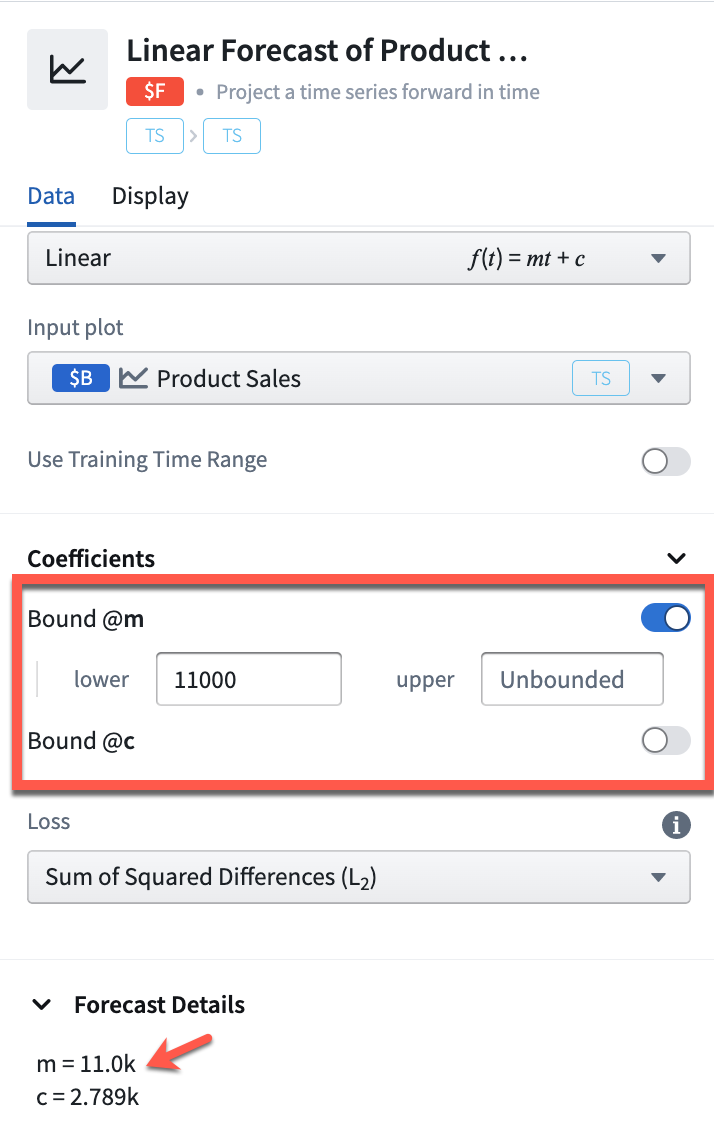
Coefficients에서 제한할 계수의 토글을 켜고 경계를 정합니다. 한 계수의 범위를 제한하면 적합 과정에서 다른 계수도 달라질 수 있습니다. 예를 들어 기울기 제한은 기울기와 절편 모두에 영향을 줍니다.
손실 함수
손실 선택을 지원하는 예측 유형에서는 학습 데이터와 예측의 차이를 어떻게 평가할지 정합니다. 적합 과정은 선택한 손실을 최소화하는 계수를 찾습니다. 기본 항목은 Sum of squared differences이며 Sum of absolute differences 또는 Maximum absolute difference를 선택할 수도 있습니다.
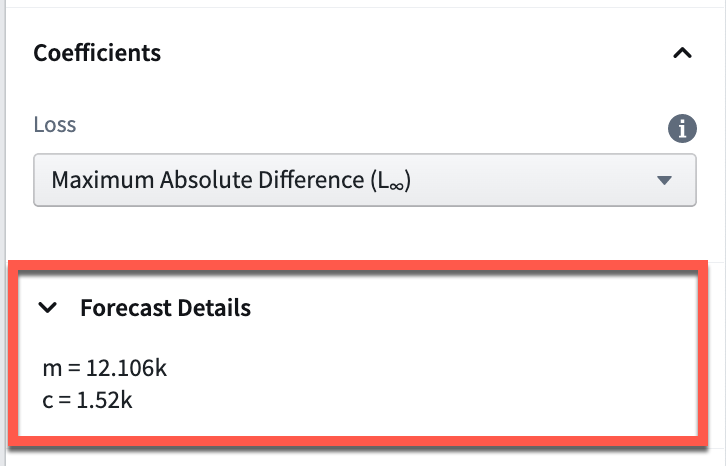
손실 정의를 바꾸면 같은 학습 데이터에서도 적합한 계수가 달라질 수 있습니다. 각 손실의 계산식은 아래에 설명합니다.
Constant
예측할 값 y가 일정하다고 가정합니다.
y = a
예시 데이터의 기울기와 주기성은 상수 하나로 표현하지 못합니다.
Linear
값이 선형 추세를 따른다고 가정합니다.
y = a*t + b
선형 모델은 예시의 기울기를 나타내지만 주기성을 모델링하지는 않습니다.
Formula
값이 지정한 식 y = f(t)를 따른다고 가정합니다. 온도의 일별 또는 연간 변화처럼 주기적인 물리 과정에는 사인 곡선을 적합할 수 있습니다.
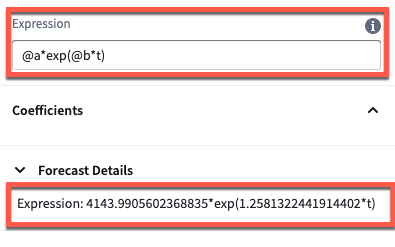
지수 함수의 예시는 다음과 같습니다.
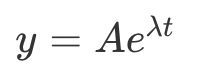
사인 함수 예시는 y = a sin(ωt) + φ입니다.
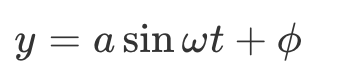
지수식으로 예측한 예시에서는 모델이 정한 계수를 Forecast details의 식에서 확인할 수 있습니다.
ODE
상미분방정식(Ordinary differential equation, ODE)을 따르는 값을 예측합니다. 값 자체의 식을 지정하는 Formula와 달리 값의 변화율을 지배하는 식을 사용합니다.
1계 형태는 dy/dt = f(t, y)입니다.
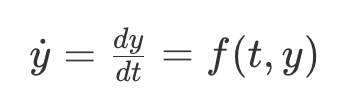
2계 형태는 d²y/dt² = f(t, y)입니다.
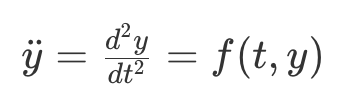
지배 방정식 예시
지수 성장 또는 감쇠는 dy/dt = λy로 표현합니다. λ가 양수이면 성장하고 음수이면 감쇠합니다.
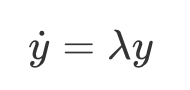
뉴턴의 제2법칙 F = m*a는 d²y/dt² = F/m 형태로 표현합니다.
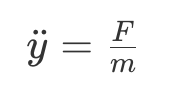
단순 조화 진동의 질량-스프링 계는 d²y/dt² = -(k/m)y 형태입니다.
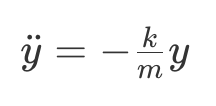
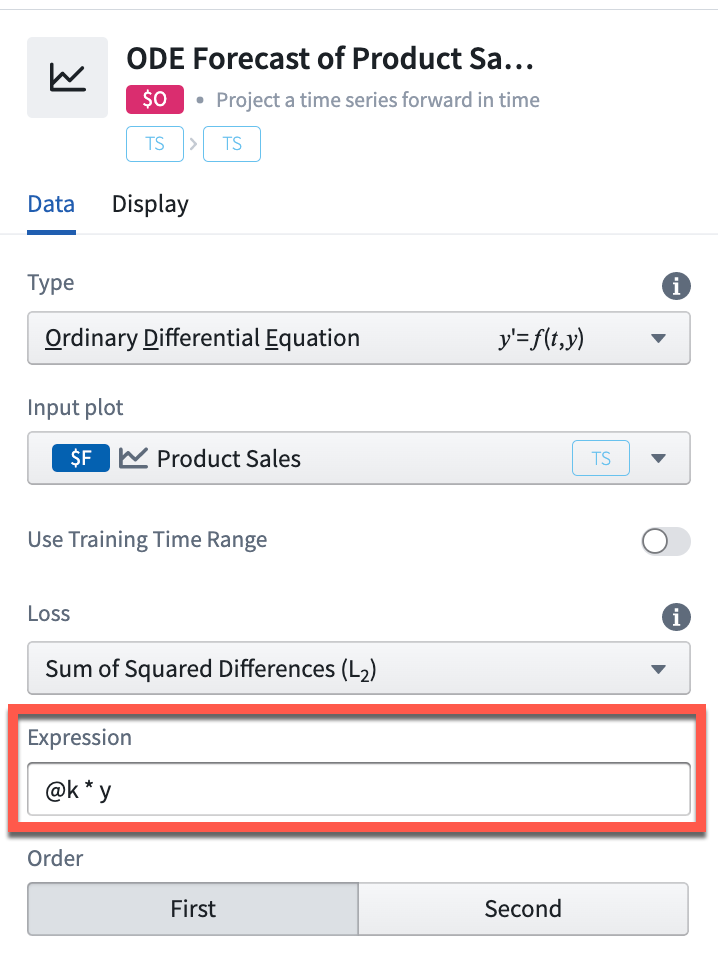
식 입력란에는 미지 계수를 @와 문자로 정의합니다. 예를 들어 y의 지수 성장률을 구성하려면 다음 식을 사용합니다.
@k * y
ARIMA
ARIMA는 자기회귀 누적 이동평균 모델입니다. 특정 요일에 구매가 집중되는 소매 매출처럼 생활 패턴에서 나타나는 주기성을 모델링할 때 사용할 수 있습니다.
비계절 ARIMA의 예측 형식은 다음과 같습니다. y_d는 연속한 값의 차이를 d번 취한 시계열입니다.
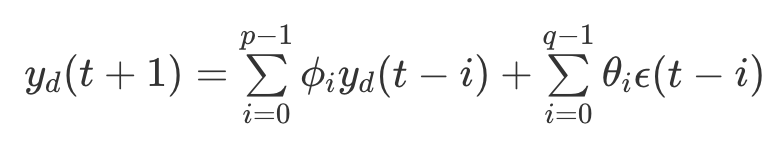
Auto와 기본 차수
Auto를 선택하면 다음 매개변수를 자동으로 정합니다.
| 매개변수 | 의미 |
|---|---|
| p | 자기회귀 항의 개수 |
| d | 차분 횟수 |
| q | 이동평균 항의 개수 |
수동으로 조정할 수도 있습니다. 수동 설정에서는 항을 불필요하게 늘리지 않도록 작은 값부터 검토합니다. Auto의 예측 적합도를 개선하려면 Maximum likelihood 적합 방법을 고려할 수 있습니다.
Seasonal
Seasonal 토글을 켜고 계절 주기를 지정합니다. 일별 데이터에 주간 주기가 있으면 7을 입력합니다.
Auto를 끈 경우에는 다음 계절 매개변수를 직접 지정할 수 있습니다.
| 매개변수 | 의미 |
|---|---|
| P | 계절 자기회귀 항의 개수 |
| D | 계절 차분 횟수 |
| Q | 계절 이동평균 항의 개수 |
손실 계산
학습 범위 안의 실제 값 y[i]와 예측값 f[i]를 비교합니다. 아래 항목은 손실 선택이 가능한 예측 유형에 적용합니다.
Sum of squared differences
기본 손실 항목입니다. 오차 제곱의 합에 제곱근을 취한 L2 노름으로 계산합니다.
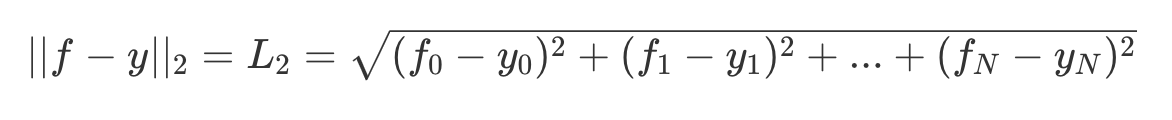
Sum of absolute differences
각 점의 절대 오차를 합한 L1 노름입니다.
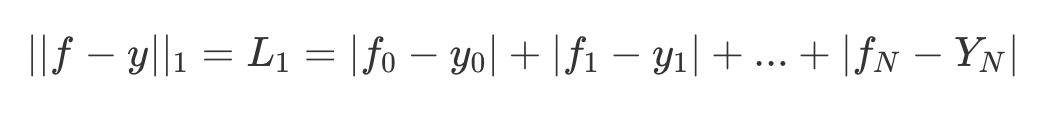
Maximum absolute difference
점별 절대 오차 중 가장 큰 값인 L∞ 노름입니다.