Dataset과 SQL 카드
Dataset 카드는 Foundry 데이터셋과 온톨로지 객체의 구체화 데이터를 분석합니다. Transform table의 조인과 변환에 적용되는 50,000행 제약을 넘는 데이터에 사용할 수 있습니다. 새 열, 필터, 집계와 조인을 계산하고 범주형 차트를 만들거나 결과를 transform table로 변환할 수 있습니다.
입력과 반환형
아래 카드는 모두 표준 Quiver 카드이며 transform table 안의 변환은 아닙니다.
| 카드 | 입력형 | 출력형 |
|---|---|---|
| Foundry dataset (Beta) | Flow start | Dataset |
| Object set dataset | Object set | Dataset |
| Filter dataset | Dataset | Dataset |
| Join datasets | Object set, Dataset | Dataset |
| Set math (dataset) | Dataset | Dataset |
| Expression | Object set, Dataset | Dataset |
| Dataset SQL | Dataset, date, number, string, Boolean | Dataset |
| Ontology SQL | Object set, Ontology SQL, date, number, string, boolean | Ontology SQL |
| Categorical plot from dataset | Dataset | Categorical chart |
Dataset 열에서 값만 가져올 때는 Numeric aggregation (dataset)과 Unique column values (dataset)을 사용합니다.
Foundry 데이터셋 가져오기
Foundry dataset (Beta)은 데이터셋을 분석에 추가합니다. 결과는 Dataset 입력을 받는 다른 카드에 연결할 수 있습니다.
이 카드는 Beta 기능이므로 플랫폼 인스턴스에서 제공되지 않을 수 있고 개발 중 동작이 바뀔 수 있습니다. 활성화가 필요하면 Palantir 지원팀에 문의합니다.
객체 집합을 Dataset으로 사용
Object set dataset은 객체 집합의 데이터를 Dataset으로 변환합니다. 객체 유형의 materialization export 데이터셋을 먼저 사용하고, 이를 사용할 수 없으면 backing datasource 데이터셋 사용을 시도합니다.
객체 집합 카드의 다음 작업에서 Datasets 아래의 카드를 추가하면 Quiver가 Object set dataset을 이용해 객체 집합을 자동 변환합니다. 변환을 직접 추가할 수도 있습니다.
카드가 사용하는 기반 데이터셋은 datasource 아이콘 위에 마우스를 올려 확인합니다.
Dataset 필터
Filter dataset은 입력 Dataset에 추가 필터 조건을 적용하고 Dataset을 반환합니다. 필터 대상 열과 조건을 편집기에서 지정합니다.
조인
Join datasets는 두 데이터셋의 left, inner 또는 right 조인을 계산합니다. 양쪽에서 유지할 열을 선택하고, 들어오는 열에 선택적으로 접두어를 붙여 이름 충돌을 피하거나 열의 출처를 표시할 수 있습니다.
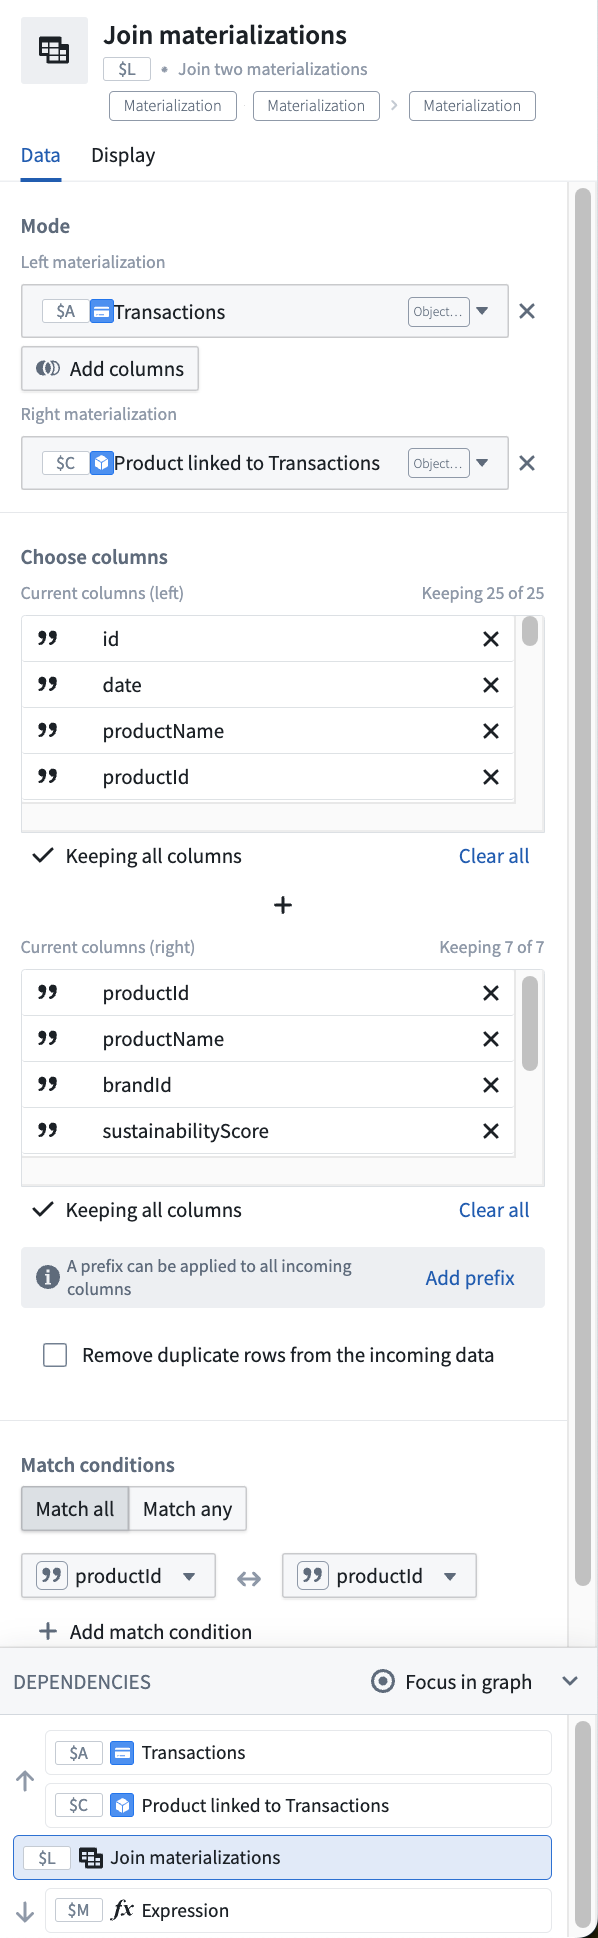
연결된 객체의 속성을 원래 객체의 속성과 같은 행에서 계산하거나 시각화할 때 사용할 수 있습니다. Switch to linked object set은 링크를 따라 대상 객체로 이동하므로 원래 객체의 정보를 같은 행에 남기지 않습니다.
50,000개 미만의 객체에서는 transform table의 Join to linked objects도 사용할 수 있습니다.
양쪽의 일치하지 않은 행도 보존하는 full outer join은 Dataset SQL의 Spark SQL JOIN 구문을 사용합니다. Join datasets 카드의 직접 선택지는 위의 세 가지입니다.
Dataset 집합 연산
Set math (dataset)은 Dataset 두 개의 합집합, 교집합 또는 차집합을 계산합니다.
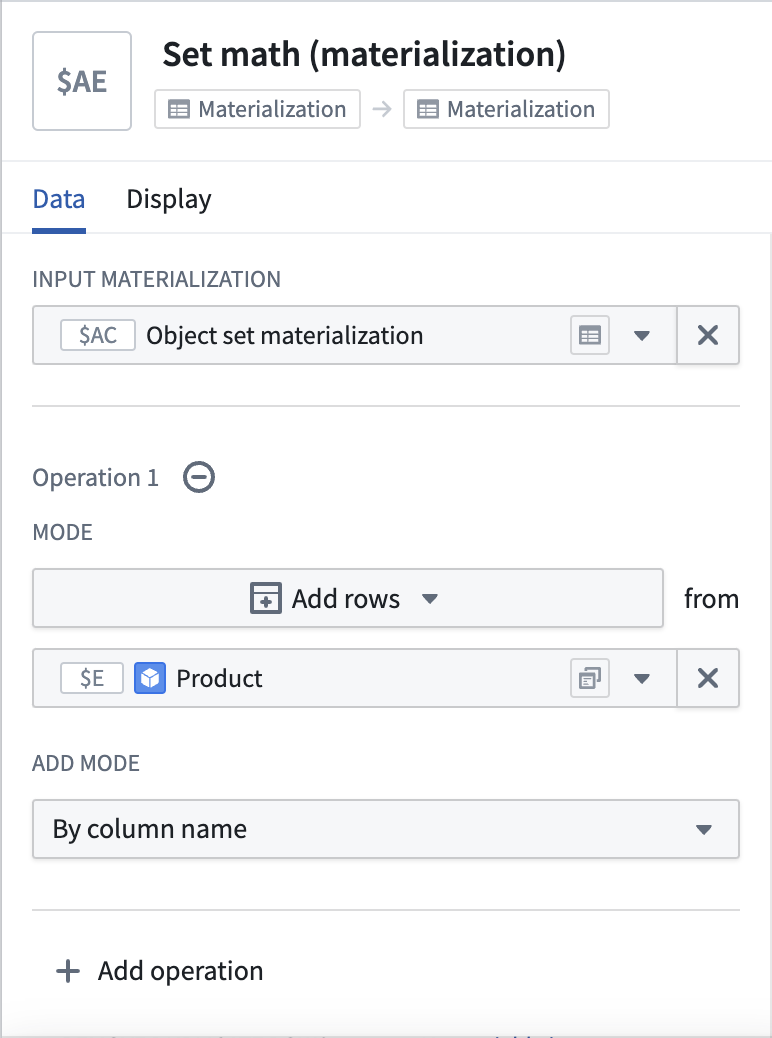
객체 유형이 같은 집합끼리 계산할 때는 객체 Set math도 사용할 수 있습니다.
Expression으로 열과 필터 계산
Expression은 표현식 언어로 새 열을 만들거나 복잡한 필터를 적용합니다. 객체 집합, Dataset 카드 또는 다른 Expression 카드의 결과를 입력으로 선택할 수 있습니다. Quiver의 일반 값 수식과 달리 윈도 함수를 포함한 Contour 표현식 구문을 사용할 수 있습니다.
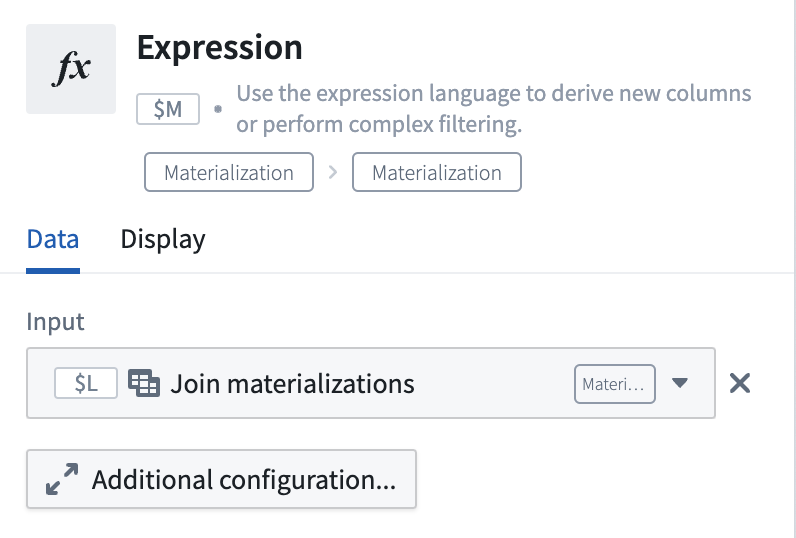
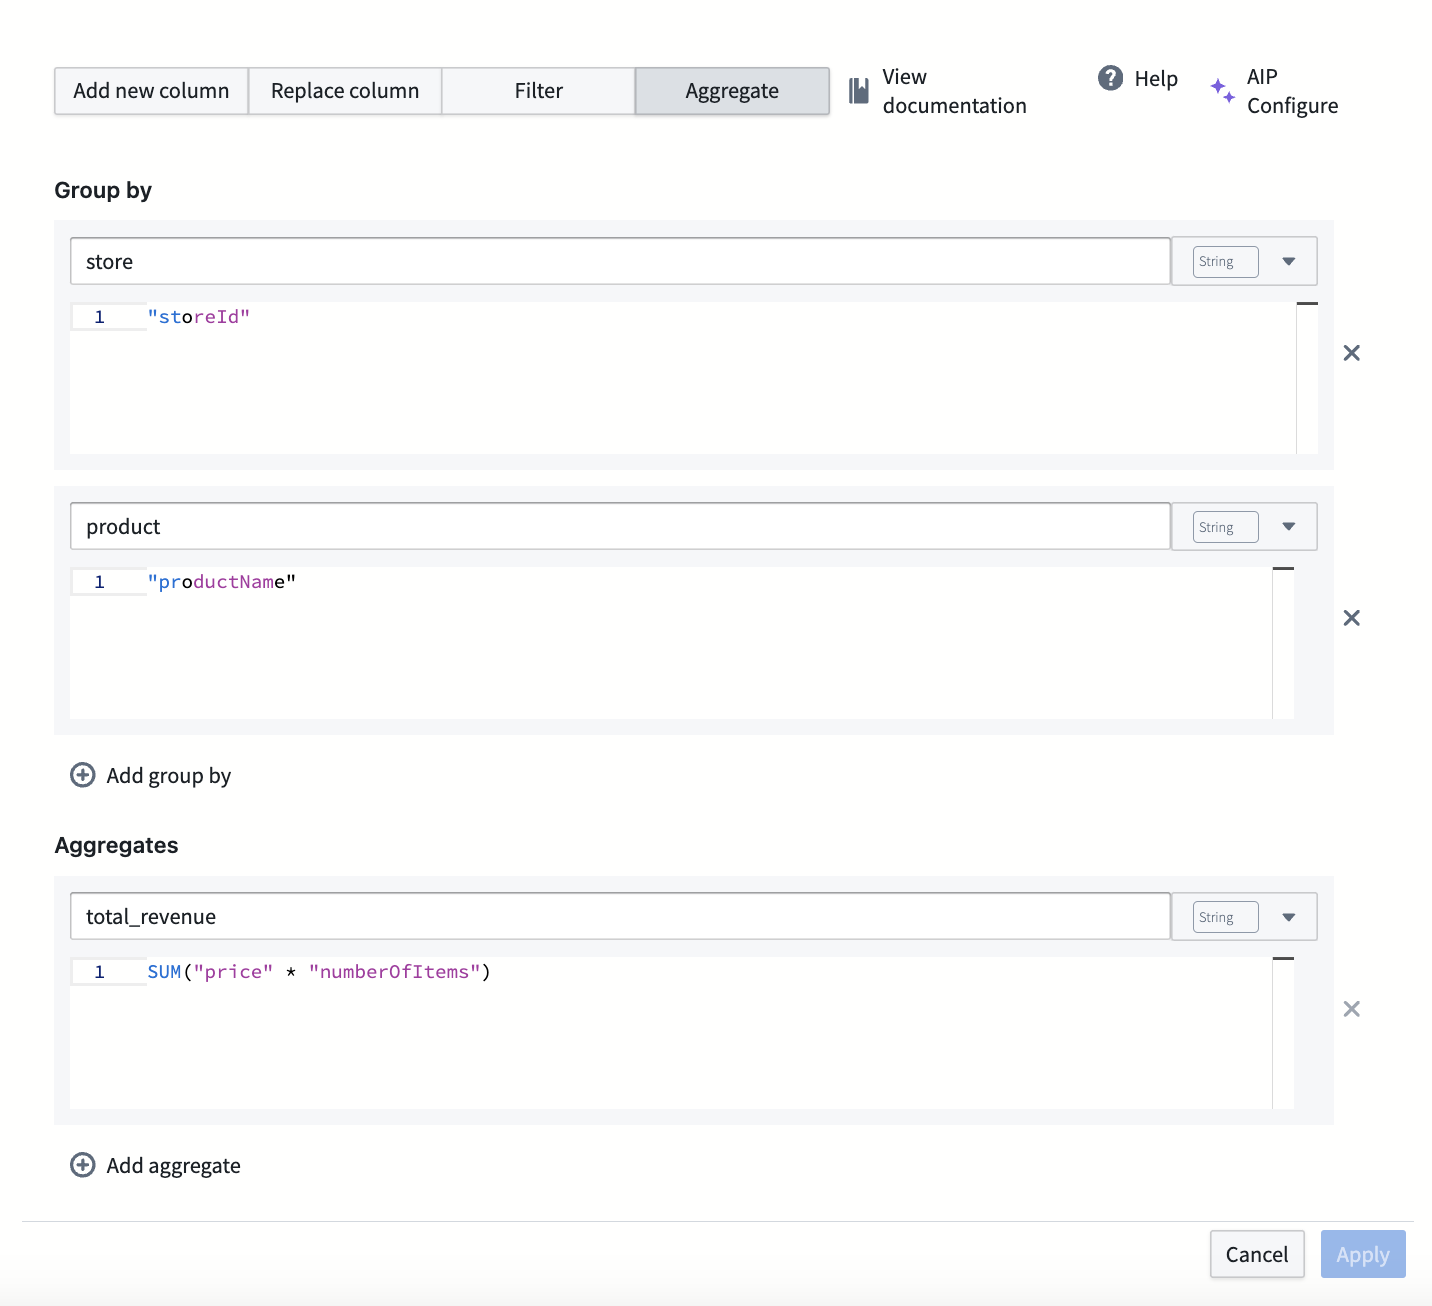
Additional configuration...에서 다음 동작을 선택합니다.
- Add new column: 새 열을 추가합니다.
- Replace column: 기존 열을 바꿉니다.
- Filter: 표현식으로 행을 필터링합니다.
- Aggregate: 집계값을 계산합니다.
AIP로 표현식 구성
AIP가 활성화된 환경에서는 Expression 카드의 AIP Configure에서 자연어로 계산을 요청할 수 있습니다. 다음은 입력 데이터의 열 이름과 목적에 맞춰 작성하는 요청 예시입니다.
- 두 점수 열을 곱하여 total user score라는 새 열을 만듭니다.
- organic 범주별로 두 점수 열을 곱한 total user score를 계산합니다.
- organic 범주별 평균 sustainability score를 계산합니다.
- Organic 열의 값을 camel case로 바꿉니다.
- 두 상품명 열을 연결하여 그중 한 열에 저장합니다.
- 가격과 판매 수량을 이용하여 매장별 상품 매출 합계를 계산합니다.
제안된 표현식을 확인한 뒤 Apply로 적용합니다.
Dataset SQL
Dataset SQL은 분석에 있는 Dataset을 Spark SQL 구문, 함수와 연산자로 조회합니다. Dataset 카드를 입력으로 받고 날짜, 숫자, 문자열 및 Boolean 값으로 질의를 매개변수화할 수 있습니다. 결과형은 Dataset입니다.
객체 집합을 SQL로 조회할 때는 Ontology SQL을 우선 사용합니다. 필요한 연산을 Ontology SQL이 지원하지 않는 경우 등에 Dataset SQL을 사용합니다.
AIP를 이용한 SQL 생성도 지원합니다. 분석 목적을 자연어로 설명하면 해당 목적의 SQL 질의를 생성합니다.
Ontology SQL
Ontology SQL은 객체 집합을 표로 참조하여 선택, 필터, 조인과 집계를 수행합니다. 다른 Ontology SQL 카드를 입력으로 연결하여 질의를 단계별로 구성할 수도 있습니다. 날짜, 숫자, 문자열과 Boolean 스칼라 값을 매개변수로 받을 수 있습니다.
결과는 Dataset과 구분되는 Ontology SQL 데이터형입니다. 후속 변환이나 차트 작성에는 결과를 Transform table로 바꿀 수 있습니다. 변환 뒤에는 transform table의 행 수 및 계산 제약을 따릅니다.
Ontology SQL은 Beta 단계이며 일부 기능이 플랫폼 인스턴스에 없을 수 있습니다. 사용 가능한 연산은 Ontology SQL과 SQL 함수 참조를 확인합니다.
이 카드도 AIP 기반 SQL 생성을 지원합니다. 객체 집합에 적용할 분석을 자연어로 설명하여 질의를 생성할 수 있습니다.
Dataset에서 범주형 차트 만들기
Categorical plot from dataset은 막대, 선 또는 범주형 산점도 차트를 만듭니다.
- Data 탭에서 입력 Dataset을 선택합니다.
- 그룹을 정의하고 필요한 경우 segment를 추가합니다.
- 집계 지표로 min, max, sum, average, count 또는 unique count를 선택합니다.
- Display 탭에서 시각화 유형과 표시 설정을 정합니다.
Dataset을 transform table로 바꾼 뒤 Vega 플롯을 사용할 수도 있습니다. 이때는 변환 후의 표와 Vega 입력 한도를 적용합니다.